第四章 聚宽获取典型常用数据
这篇主要教大家怎么快速获取聚宽的指数成分股,股票行情数据,股票财务数据。
1. 聚宽数据
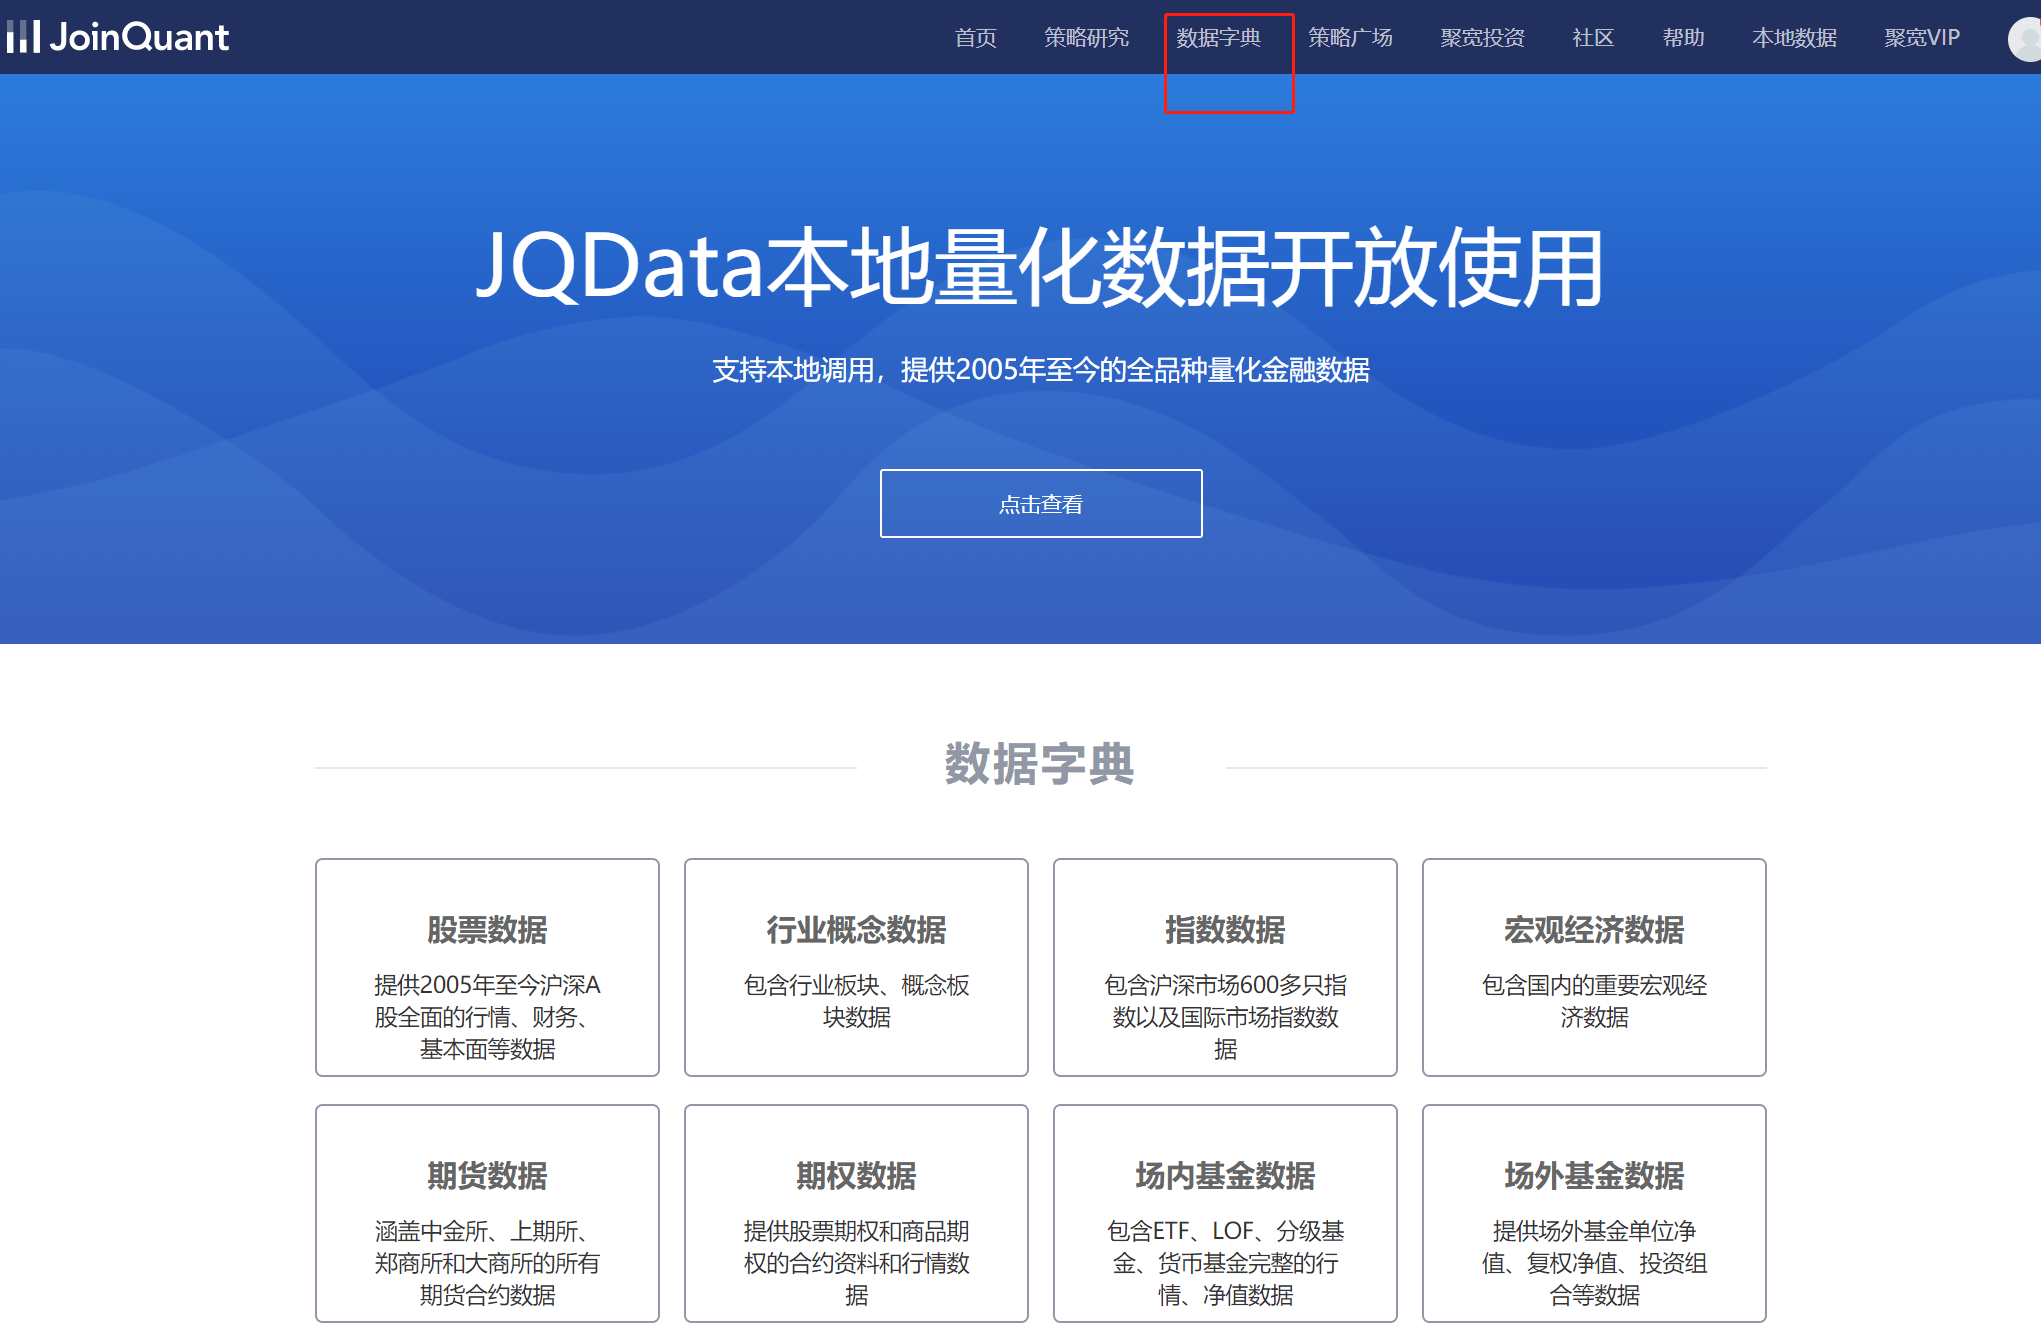
在聚宽数据这个页面可以看到聚宽平台集成好的各大类数据,如下图所示,点击可以查看详情与用法。
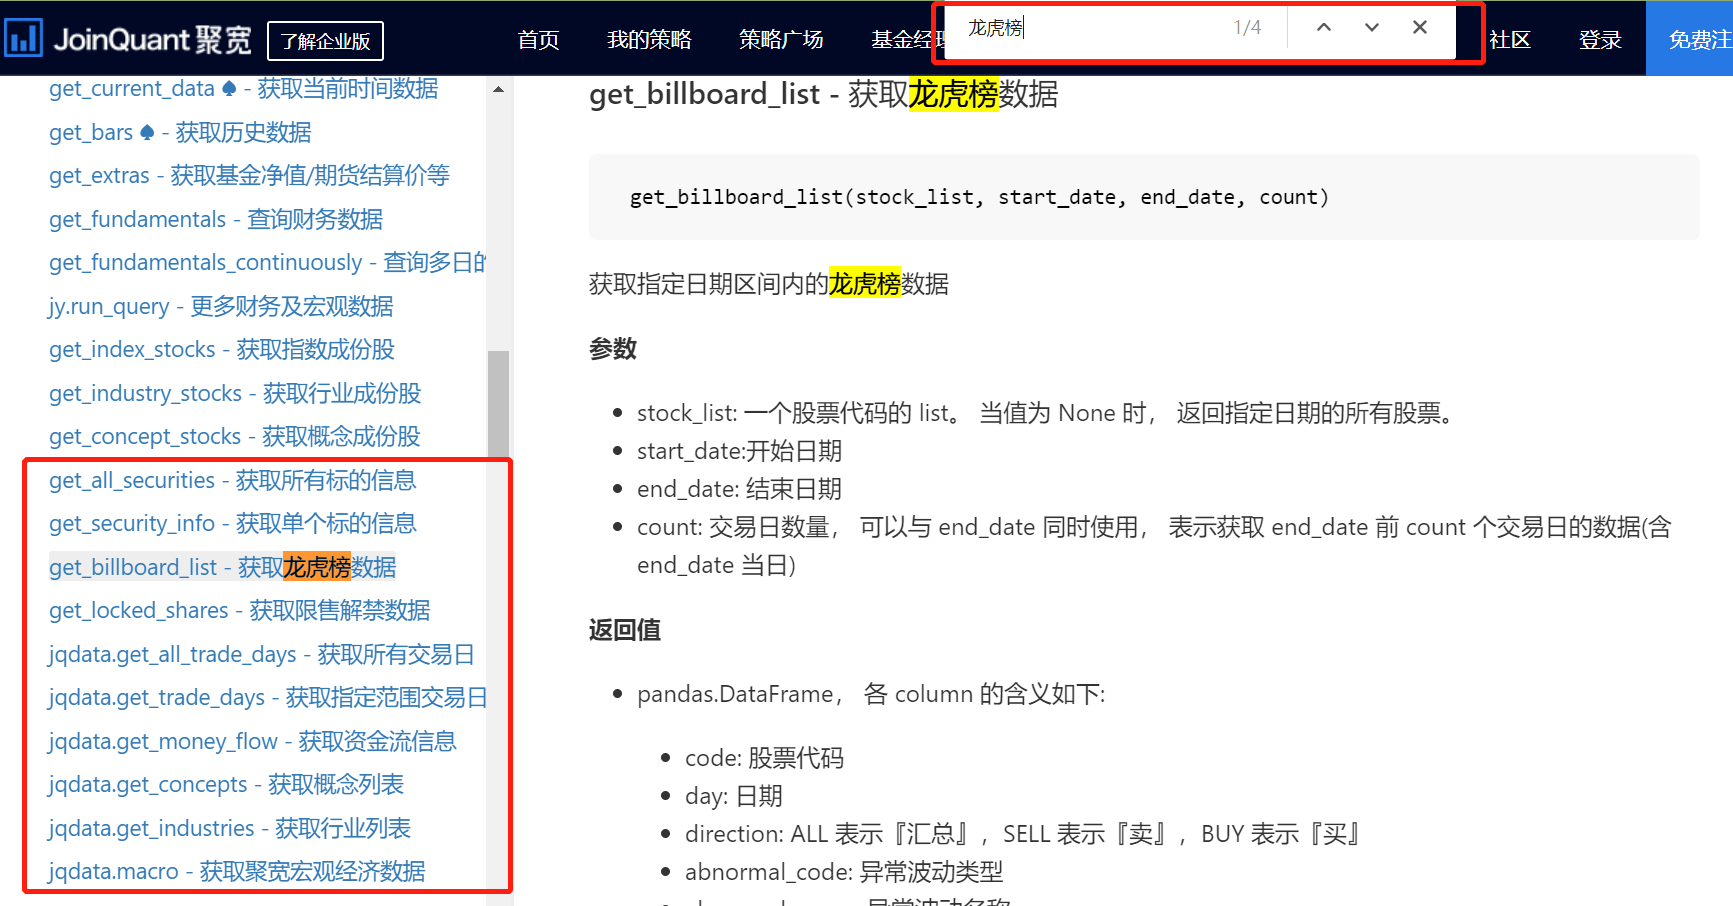
但实际上可能有些数据要在 API 文档里才比较容易能找到,比如龙虎榜数据等。这时用 CTRL+F 进行网页搜索可以快速搜索需要的数据。
接下来会介绍几种常用数据的取用方法,这些取用方法比较典型,掌握后能覆盖基本的数据需求以及较容易的学会使用其他数据。
2. 获取指数成分股
以免有人不知道指数成分股是什么,简单说明下。为了衡量股市中某一大类股票整体的涨跌情况,通常会用这一类的股票加权平均编制出一个指数,而这些股票则叫做该指数的成分股,一般指数的成分股选取会变动。比如上证指数是用所有上交所的股票编制而成,可以衡量上交所股票整体的涨跌情况,有的股票退市了也就会被剔除成分股。比较常见的指数有上证指数、深证综指、创业板指、沪深300指数、中证500指数、上证50指数等。可以在数据-指数数据-指数列表中找到聚宽支持的指数及其指数代码。同样要善用 CTRL+F 进行搜索。
获取指数成分股需要用到的 API 函数为 get_index_stocks,可以获取一个指数给定日期在平台可交易的成分股列表,请点击指数列表查看指数信息。:
之前讲过怎么看 API 文档以及函数参数的含义,现在应该能直接看说明使用了。补充一个更详细点的例子应该就会用了。
3. 获取股票行情数据
此处的股票行情数据指SecurityUnitData 里面的所有基本属性,以下列举类常用字段,详情请看文档。
open: 时间段开始时价格close: 时间段结束时价格low: 最低价high: 最高价volume: 成交的股票数量money: 成交的金额factor: 前复权因子avg: 这段时间的平均价pre_close: 前一个单位时间结束时的价格paused: 这只股票是否停牌,是则为1,否则为0
3.1 history
通过 history 函数可以获取历史数据,可查询多个标的单个数据字段,返回数据格式为 DataFrame 或 Dict。
-
可以同时获得多个股票的数据,但只能获得相同的一个数据字段。如获得 “平安银行,建设银行,农业银行” 这 3 只股票的前3天交易额。
-
默认不跳过不交易日期,由
skip_paused参数控制。 df参数控制返回结果的数据类型,默认是True代表dataframe类型,稍后我们会讲到,当df为False时就为之前讲过的dict类型。fq参数控制复权方式,往往可以不管它直接用默认的前复权即可。复权的含义不难,解释略麻烦,建议自行搜索学习下。
接下来介绍的 API 还会有 skip_paused、df、fq 参数,就不再提了。这三个参数新手可以以后慢慢了解,现在不管也没关系,如果不想用dataframe,会把 df 参数调成 False 就行。
3.2 attribute_history
attribute_history 也是用于获取历史数据,但只能获取单独一个股票的数据,但可以同时获得多个字段的数据。例如,获得“平安银行”这一只股票,前3天的交易额,交易量,最高价,最低价等。默认跳过不交易日期,由skip_paused 参数控制。
| 示例 | |
|---|---|
返回的财务数据是 DataFrame 类型,这是一种二维表结构的功能强大的数据类型,常用于数据处理与分析。
4. 获取股票财务数据
股票财务数据这里是指发股票的公司发布的财务报表中的数据。可以在聚宽数据-股票财务数据 查看数据详情。
财务报表简称财报,是用来向股东汇报企业经营情况的,上市公司必须按季度公布财报,一年有四季所以财报依发布次序一季报、半年报(也称中报)、三季报、年报,而具体的发布日期在一定期限内即可并非固定,年报要求年度结束四个月内披露,半年报是上半年结束后两个月内,一季报与三季报是季度结束后一个月内。特别的是像总市值、市盈率这种跟股价挂钩的市值数据是每天更新的。
4.1 get_fundamentals
获取股票财务数据需要用到的 API 为 get_fundamentals,这个语句的用法较为复杂,下文对文档进行补充说明,文档还是要看的。
4.2 未来函数是什么?
我们做回测去验证策略时,其实是用历史数据去模拟当时的市场从而得知策略在历史上表现如何,但是如果策略利用了历史当时无法得到的信息,往往就会造成回测结果极大失真,这时我们会说这个策略有未来函数。
举一个典型的有未来函数的策略:每天买明天涨停的股票。事实上你是不能知道明天哪个股票涨停的,所以现实中是不能实现的,但是我们做回测是用的历史数据,所以我们其实是能实现用 2012 年的数据对这个买明日涨停股的策略做回测的,毕竟现在已经过了 2012 年,2012 年每天哪个股票会涨都是已经知道的了。这样的有未来函数的回测结果肯定是没价值的,因为现实中不能实现,尽管回测结果有时特别喜人。
4.3 单季度与报告期
之前讲过,财务数据按季度发布,一般财经网站上提供的财务数据是默认按报告期提供的,即每季度统计的周期跨度分别为第一季度、前两个季度、前三个季度、前四个季度(全年)。
而聚宽考虑到量化分析,提供的财务数据全是单季度的,即每季度统计的周期跨度分别为第一季度、第二季度、第三季度、第四季度。
因此,当你发现聚宽财务数据比财经网站的财务数据差的很多时,很可能是单季度与报告期的差别造成的。
4.4 query_object参数以及快速上手模板
query_object 参数是要求传入一个 Query 对象用于描述所需的数据,这个东西展开讲相当于一门小的编程语言,麻烦而不必要,这里提供一个快速上手的模板用来产生 query_object 参数,多数情况下往里套就可以了,例子如下,建议对比文档里的例子看看。
表和字段可以在财务数据文档查看,如下。表和字段可以写多个用逗号隔开,只写表名不写字段代表选择该表的所有字段。注意看含义与单位。
筛选条件跟讲 if 判断时用的条件是一样的,多个条件用逗号隔开代表与(and)的关系。特别的是要用复杂的与或非的逻辑关系时,在此处 and、or、not 是不能用的,要对应的改用 &(与)、|(或)、~(非)。
排序的写法比较简单,就是要作为排序标准的字段后面加 .desc() 即由大到小,或 .asc() 即由小到大。
数量上限可以自己设置,代表最多返回的数据条数。不过系统强制限制每次最多返回 10000 条,就算你自己在此处限制比 10000 多也没用。
| 模板 | |
|---|---|
5. 自学与自测
实践下文中例子:
- 浏览聚宽数据中包括的数据,试着取用下。
- 获取任一股票最近 5 个交易日最高价的平均价。
- 生成一个
list,list中为上证指数成分股中流通市值最大的 5 个股票的股票代码。